

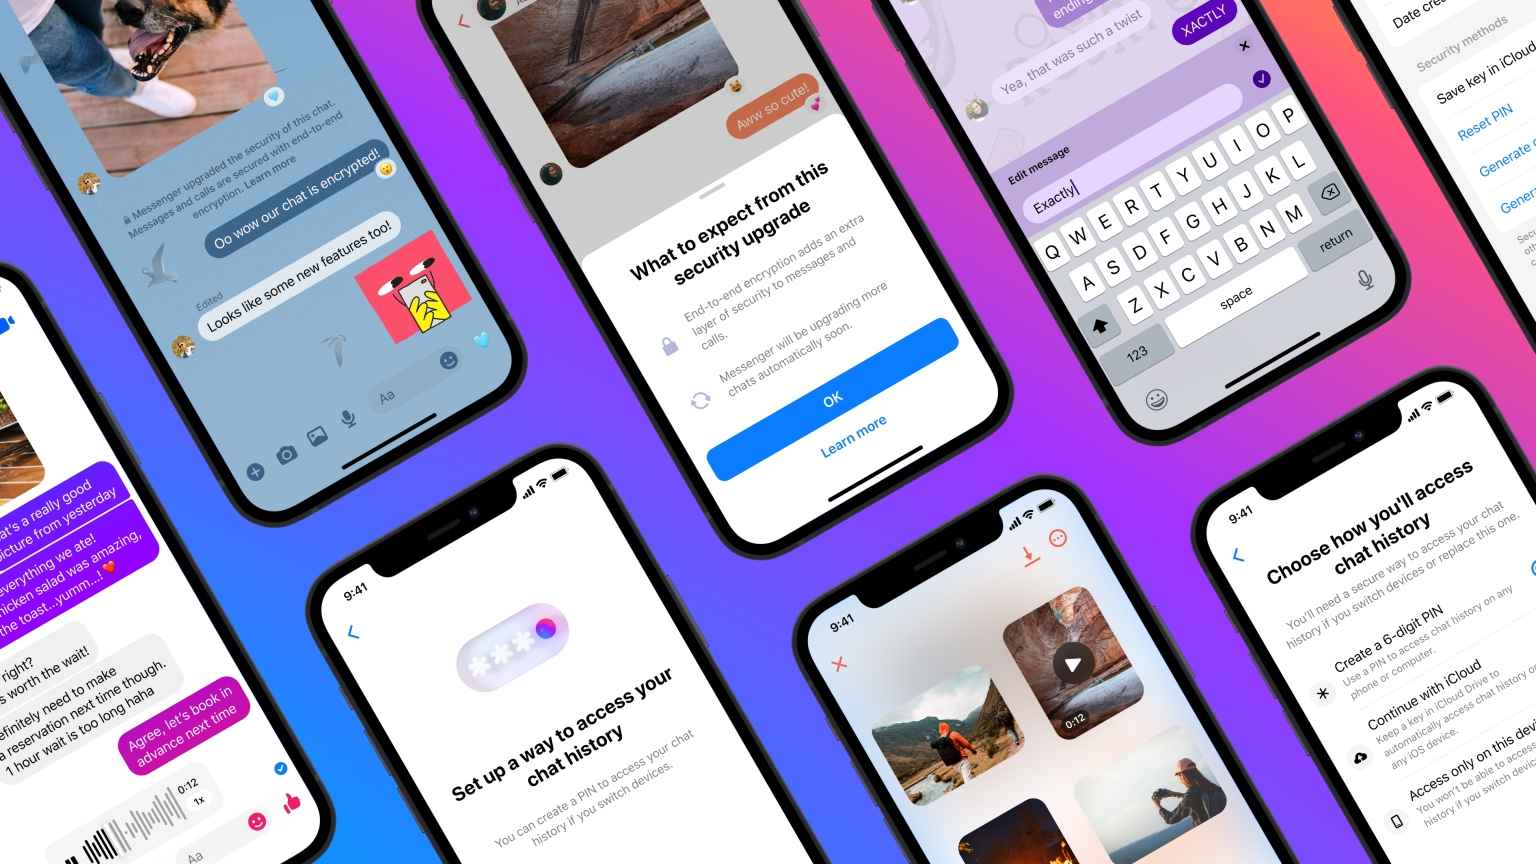
Meta reaguje na sťažnosti zbierania údajov

Meta bude zbierať menej osobných údajov, ustúpila kritike.
 Pridajte si TOUCHIT.sk ako preferovaný zdroj informácií
Meta zo svojich obchodných podmienok odstránila ustanovenie, ktoré bolo terčom kritiky kvôli obavám z možného zbierania obsahu spravodajských webov. Tieto dáta by mohli byť využívané pri trénovaní AI.
Podmienky zároveň uvádzali, že Meta môže získaný obsah používať na vývoj, zlepšovanie, výskum či trénovanie svojich produktov a služieb. Práve toto vyvolalo otázky, či by firma mohla zbierať obsah spravodajských portálov bez licenčnej dohody a následne ho použiť pri vývoji vlastných AI modelov.
Vlastník Facebooku sa voči kritike ohradil. Zástupcovia firmy tvrdia, že zmena podmienok neznamenala zmenu, akým jej algoritmy používajú webové prehľadávanie. Sporné ustanovenia sa týkali najmä reklamných a firemných produktov, nie všeobecného oprávnenia zbierať spravodajský obsah na trénovanie AI.
Prístup na weby sa dá obmedziť
Vlastníci webových stránok môžu naďalej používať súbor robots.txt, kde budú zaznamenané preferencie automatizovaného prístupu. Tento súbor umožňuje prevádzkovateľom webov určiť, ku ktorým častiam stránky môžu automatizované systémy pristupovať. Tu treba rozlišovať medzi technický a právnym definovaním.
Súbor robots.txt sám osebe nedokáže zabrániť robotovi v prístupe na web. Jeho rešpektovanie závisí od správania konkrétneho systému a od ďalších právnych či technických opatrení. Minimálne je to ale ochrana pre weby, ak by sa chceli sťažovať, že robot niektorej firmy nerešpektuje nastavenia zberu dát z webov (tzv. scrapping).
Zdroj: The Verge
Prečítajte si aj:
17. septembra 2026
2m
Meta One AI: Na Slovensku je výhodnejšie predplatné


Populárne z kategórie Bezpečnosť
20. októbra 2026
2m
Proton ukázal pripravované novinky na rok 2026
13. októbra 2026
3m
Je inštalácia dvoch antivírusov vo Windowse dobrý nápad?
8. októbra 2026
2m
V Portugalsku sa objavil nový typ podvodu s bankovými kartami
Podobné články
8. októbra 2026
2m
Európska komisia dostáva sťažnosti na YouTube sťahovače a VPN služby
4. októbra 2026
8m
Ako bezpečne nakupovať na internete?

2. októbra 2026
3m
Chat Control 2.0 zatiaľ neprešiel, plošné sledovanie našich správ sa odkladá
23. septembra 2026
9m
Vedeli ste, že používanie AI vo firme je riziko?
16. septembra 2026
2m
V USA zakazujú routery, no konkrétne modely môžu získať výnimku
2. septembra 2026
1m
Instagram bude trestať AI profily, ktoré sa tvária ako skutočné
27. augusta 2026
2m