

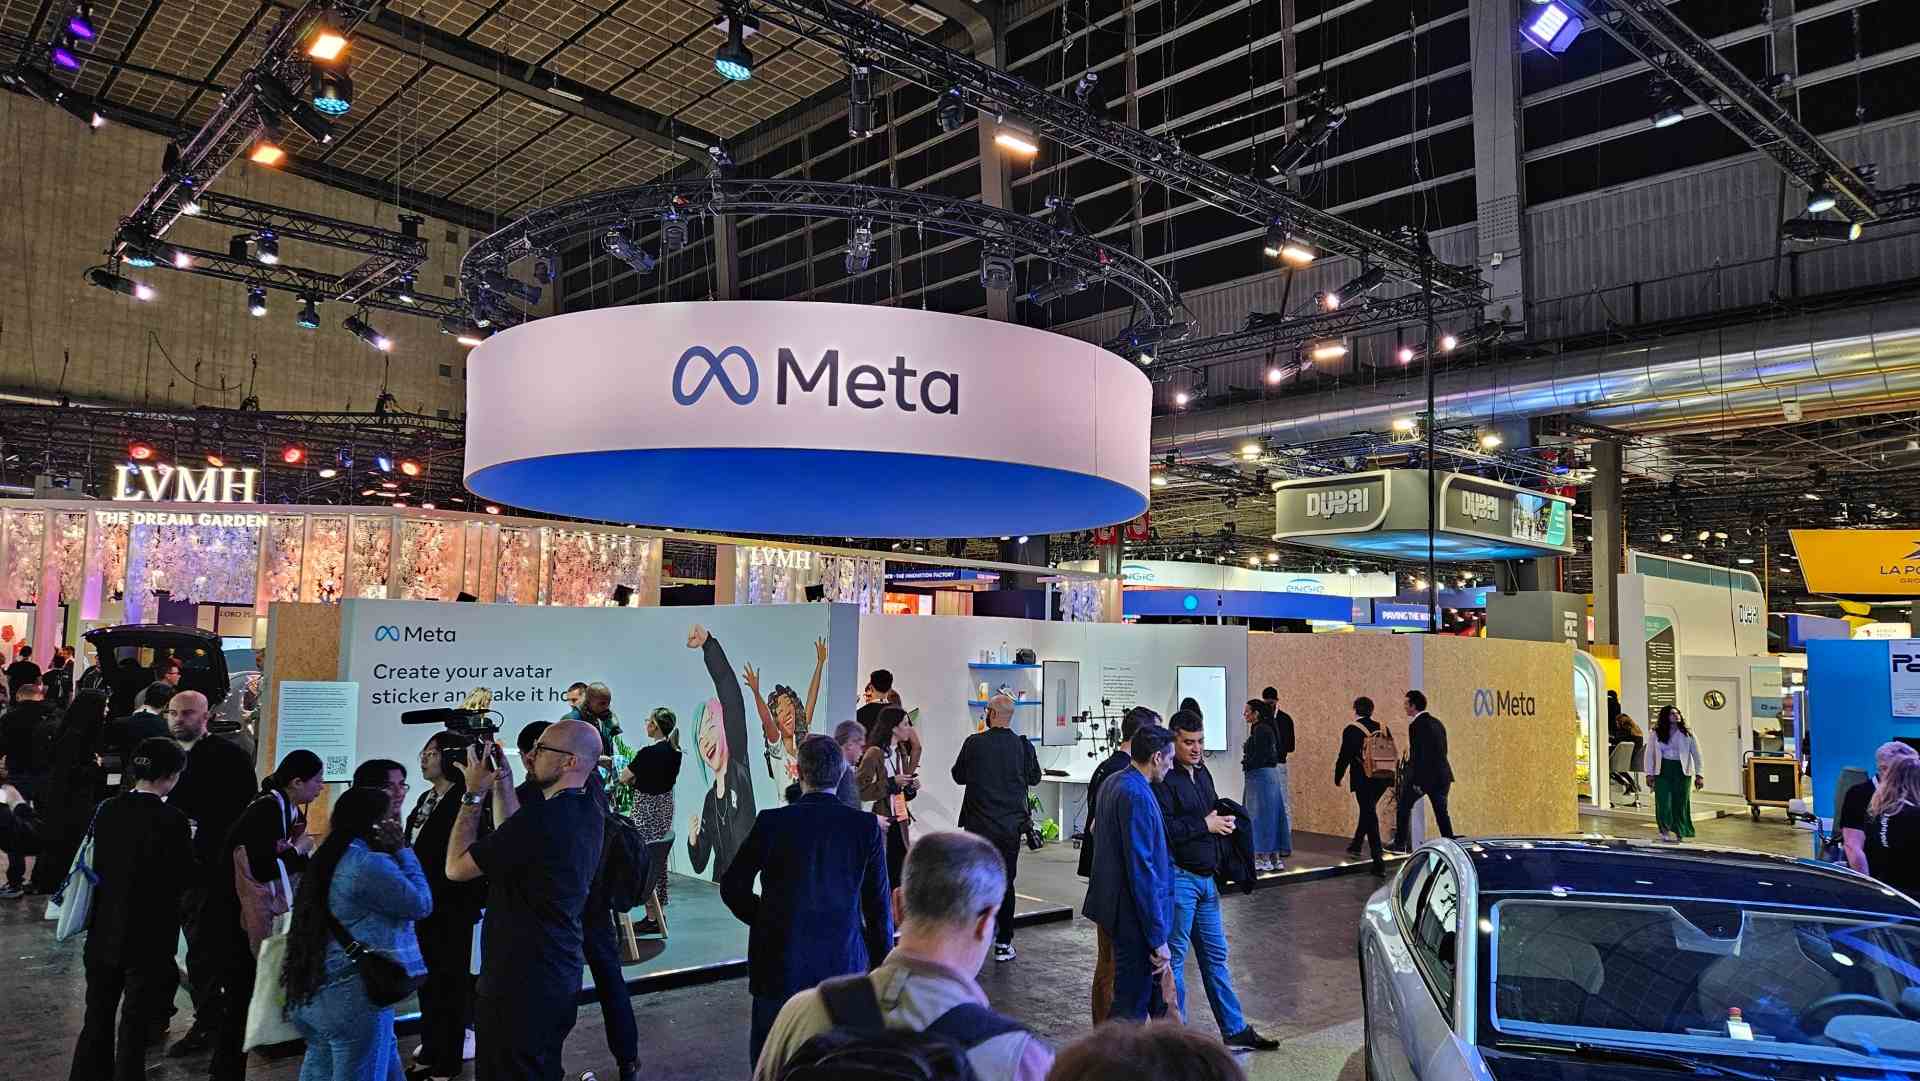
Meta trénovala svoj AI model aj na ukradnutých knihách

Meta trénovala AI modely na ukradnutých dátach.
Nebola by prvá a AI spoločnosti trénujú svoje modely na rôznych dátach, ktoré sa hýbu v akejsi sivej zóne alebo sú úplne za čiarou. Tréning modelu Llama bol založený na 81,7 TB dát z pirátskeho obsahu kníh na internete. Ide o informáciu podľa novej žaloby podanej na okresnom súde v Kalifornii.
Sieť torrent tvorená nezávislými uzlami (počítačmi ľudí) môže obsahovať aj nelegálny obsah. Takýto obsah si zobrala aj Meta a autorsky chránené diela vrátane zdrojov Z-Library a LibGen poslúžili na svoje účely s AI. Vyšetrovanie tohto prípadu potvrdili aj zamestnanci spoločnosti. Žalobu podali autori kníh, ktorí hovoria o nezákonnosti stiahnutia ich diel.
7. februára 2025
1m
Nepoužívajte DeepSeek na zariadeniach s iOS


Podobné články
22. októbra 2026
2m
ChatGPT umožňuje uzamknúť konverzácie PIN kódom
21. októbra 2026
4m
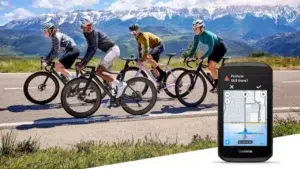
Garmin predstavil nové cyklopočítače. Môžete ich ovládať aj hlasom

21. októbra 2026
3m
Nové dvojčíslo TOUCHIT september/október 2026 už v predaji
21. októbra 2026
2m
Meta reaguje na sťažnosti za zber údajov
21. októbra 2026
2m